
Loop Engineering: באזז מנופח או שינוי אמיתי באיך סוכני קוד עובדים?
מאתגלעד דור לוי
כולם מדברים על Loop Engineering, אבל כמעט אף אחד לא מגדיר אותו אותו דבר. הנה מה שבאמת קורה מתחת למכסה המנוע - ולמה שאלת העצירה היא זו שבאמת קובעת.

כשמריצים שבועות מייסד OpenClaw כתב שאסור להמשיך "לתת פרומפט" לסוכני קוד - אלא לבנות סביבם לולאות. בוריס צ'רני, האדם מאחורי Claude Code, הצטרף ואמר שהוא כבר לא כותב פרומפטים לקלוד בעצמו - הוא כותב לולאות שמריצות את קלוד עבורו. הפוסטים האלה עוררו ויכוח סוער: חלק קוראים לזה שינוי דורות בעבודה עם סוכני AI, וחלק מפתחים טוענים שזה סתם while loop ו-cron job עטופים במילה מנופחת כדי להצדיק צריכה לשרוף יותר טוקנים. שני הצדדים צודקים בערך דומה - וההבדל האמיתי נמצא בפרט טכני קטן שקל לפספס.
מה בעצם קורה בתוך "לולאת" סוכן קוד
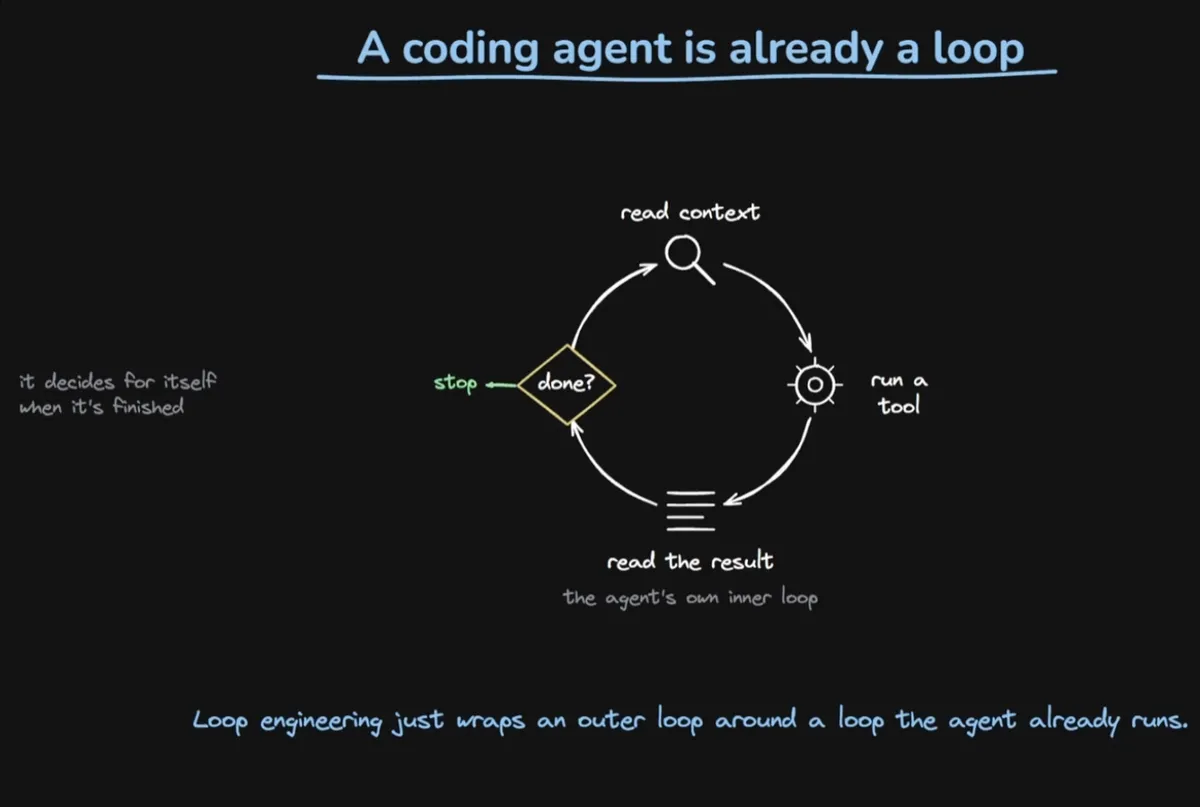
כשמריצים היום פקודה בודדת לסוכן קוד כמו Claude Code, קל לחשוב על זה כ"קלט אחד, תשובה אחת". אבל בפועל הסוכן כבר מריץ לולאה פנימית משלו: הוא קורא הקשר, מפעיל כלי (למשל עריכת קובץ או הרצת בדיקה), קורא את התוצאה, וחוזר חלילה - עד שהוא מחליט בעצמו שהמשימה הושלמה ועוצר. כל סוכן כבר מגיע עם לולאה כזו מובנית.
Loop engineering, במובן הזה, אינו הלולאה הפנימית הזו - הוא הלולאה החיצונית שעוטפת את כל התהליך: מנגנון נוסף שמחליט מתי להריץ את הסוכן שוב, מתי לעצור אותו לגמרי, ומתי לשלוח אותו בחזרה לעבודה נוספת. וככל שיצרני סוכני הקוד מוסיפים יותר יכולות לולאה מובנות משלהם, הגבול בין "פנימי" ל"חיצוני" הולך ומיטשטש.
ארבע רמות של Loop Engineering
צוות Claude Code מיפה את זה לארבע רמות, מהפשוטה למורכבת ביותר:
- מבוססת-תור (turn-based) - הברירת המחדל של כל סוכן קוד. נותנים פרומפט, הסוכן אוסף הקשר, פועל, מאמת בעצמו את התוצאה, וחוזר על כך כמה שצריך. ההחלטה "האם זה מוכן" נמצאת כולה בידי הסוכן הראשי עצמו.
- מבוססת-מטרה (goal-based) - כאן כבר נכנס מודל שני, נפרד וקטן, שתפקידו היחיד הוא לבדוק אחרי כל סבב אם קריטריון ההצלחה שהוגדר התממש. אם לא - הוא שולח את הסוכן הראשי לעוד סבב, עד שהיעד מושג או שמגיעים למספר ניסיונות מקסימלי.
- מבוססת-זמן (time-based) - הסוכן פשוט מופעל מחדש לפי לוח זמנים קבועים, מקומית או בענן. זה למעשה פשוט cron job - ואין בזה בשום רע, זה עובד.
- פרואקטיבית - שילוב של שלושת הרמות הקודמות: טריגר (זמן או webhook) שמפעיל, מטרה שמגדירה מתי לעצור, וworkflow שמבצע את העבודה בפועל. זו הרמה שמאפשרת לסוכן לטפל בקטגוריות שלמות של משימות - טריאז' של באגים, הרצת מיגרציות - כמעט בלי מגע יד אדם.
זה לא רעיון חדש - אז למה כולם מדברים על זה עכשיו?
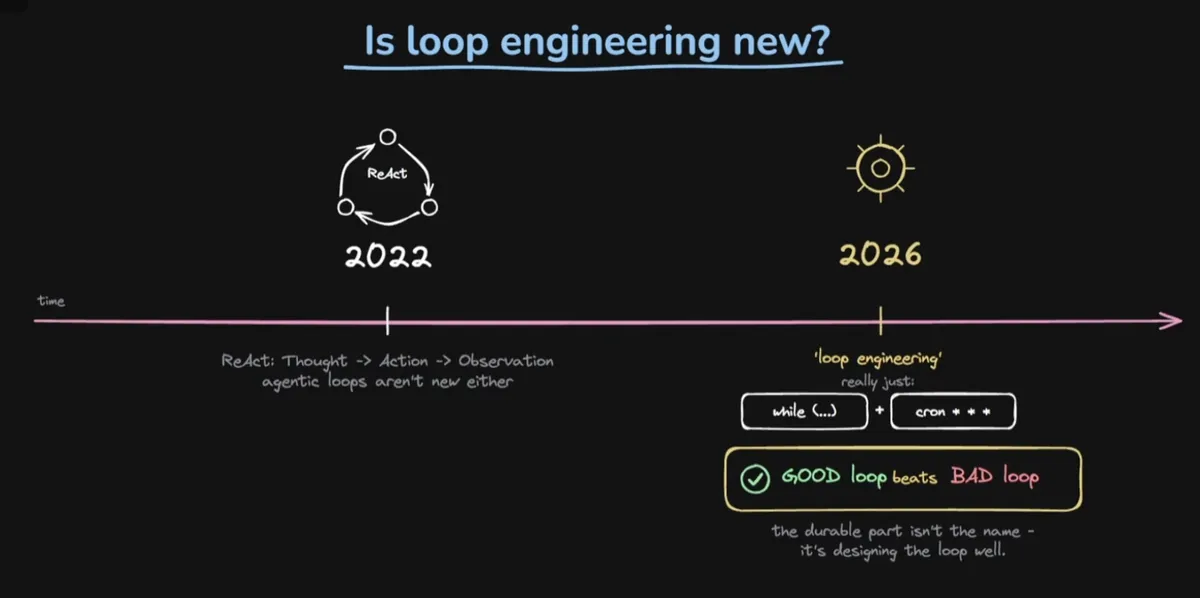
לולאות הן חלק בסיסי מתכנות כבר עשרות שנים, והדפוס שעליו מבוססים רוב הסוכנים היום (מחשבה, פעולה, תצפית - ושוב) פורסם כבר ב-2022. מבחינה טכנית, אין כאן דבר חדש. מה שכן חדש הוא שינוי הגישה: לתכנן מראש שהסוכן ירוץ באופן אוטונומי, על ציר זמן או לקראת יעד, בלי שיהיה צורך לתת לו פרומפט מחדש בכל פעם. זה שינוי גישה, לא פריצת דרך טכנולוגית.
השאלה האמיתית: מי מחליט שהעבודה נגמרה
ההגדרה שצוות Claude נתנה ללולאות - "סוכן שחוזר על מחזורי עבודה עד שתנאי עצירה מתקיים" - מתמצתת לשאלה אחת: איך בדיוק המערכת יודעת שהעבודה באמת הושלמה?
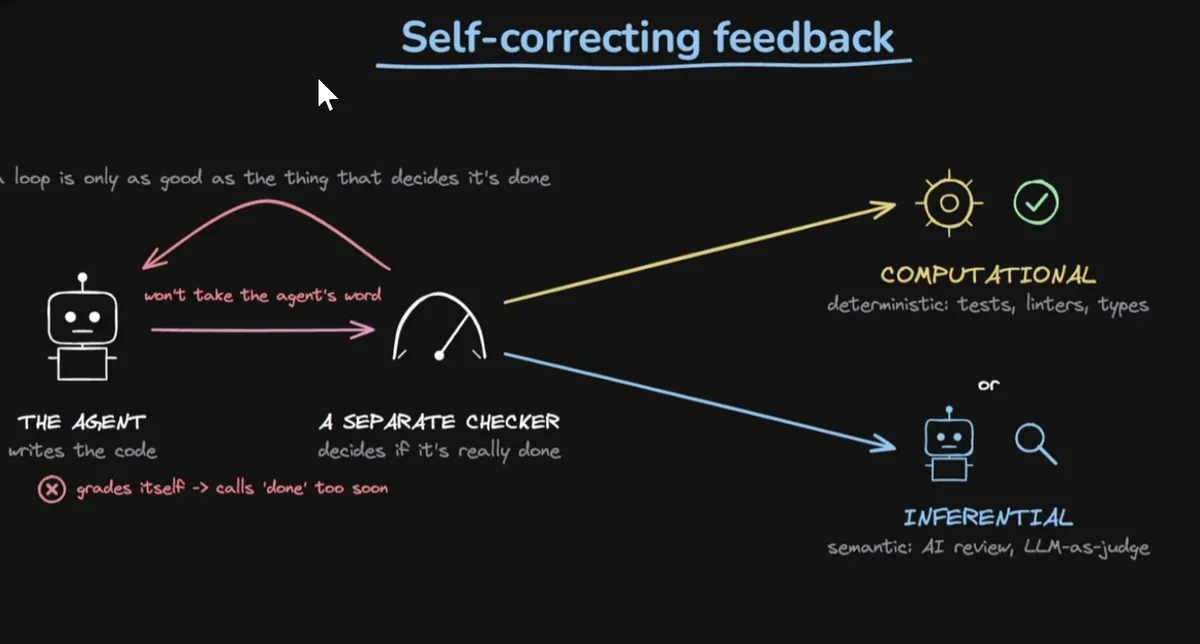
בלולאה מבוססת-מטרה, המודל המעריך קטן ומהיר בכוונה, והוא לא יכול להריץ בדיקות בעצמו, לפתוח קבצים, או לטעון מחדש דף כדי לבדוק תוצאה אמתית. כל מה שיש לו זה תמליל השיחה. אם הסוכן הראשי באמת הריץ בדיקות, התוצאות נמצאות בתמליל והמעריך יכול לקרוא אותן - אבל אם הסוכן רק טוען שהריץ בדיקות, הריץ רק חלק מהן, או שהקוד נשבר כמה סבבים קודם לכן, למעריך הקטן הזה אין דרך לדעת. הוא סומך על מה שכתוב, לא על מה שבאמת נכון.
בגלל זה, גם כשהבקרה הזו לא מושלמת, היא עדיין קריטית - כי סוכן שמוערך רק על ידי עצמו נוטה להכריז על הצלחה מוקדם מדי.
משוב חישובי מול משוב הסקתי
כדי לתת ללולאה משוב אמיתי ואמין, כדאי להבחין בין שני סוגי בדיקות:
- בדיקות חישוביות - דטרמיניסטיות, מהירות וזולות: test suites, linters, בדיקות טיפוסים, ניתוח מבני. הן רצות במילישניות עד שניות בעזרת hooks, בלי לצרוך אפילו טוקן אחד של מודל שפה, והתוצאה שלהן אמינה לגמרי.
- בדיקות הסקתיות - ביקורת קוד מבוססת AI, LLM כשופט, ניתוח סמנטי. אלה יקרות ואיטיות יותר, אבל מסוגלות לתפוס דברים שבדיקה חישובית לא תתפוס - מ-sub-agent קל שבודק לפני מיזוג, דרך ביקורת מקיפה שמפזרת כמה סוכנים על כל השינוי, ועד שופט שרץ בלולאה קבועה מול המערכת החיה. ככל שהמשוב עשיר יותר, כך הלולאה אמינה יותר - וזו בדיוק הסיבה שסוכני AI מצטיינים בכתיבת קוד (משוב מידי ואוביקטיבי) ונתקלים בביצוע בתחומים אחרים שבהם קשה יותר לבדוק אם התוצאה נכונה.
מקביליות, עצירה וטוקנים - הסיכונים המעשיים
כמה דברים כדאי לשים לב לפני שמריצים לולאות אוטונומיות בפועל:
- מקביליות - אם כמה סוכנים עובדים על אותו קוד במקביל, הם צריכים סביבות עבודה מבודדות (למשל git worktrees) כדי שלא ידרסו זה את זה. זה עובד טוב, אבל מוסיף מורכבות תפעולית.
- תקרת איטרציות - חייבת להיות הגבלה ברורה על מספר הסבבים, אחרת הלולאה עלולה לרוץ בלי סוף. הגבלה "רכה" (בקשה מהסוכן לעצור אחרי X ניסיונות) פחות אמינה מהגבלה "קשה" בקוד עצמו.
- עלות טוקנים - זה החלק שהכי קל לפספס. workflow שמריץ כמה סוכנים במקביל יכול לצרוך מיליוני טוקנים כדי להגיע ליעד בודד. כדאי לזכור שמי שדוחף בחוזקה את המונח "loop engineering" הוא לרוב מי שמרווח מכמות הטוקנים שנצרכת - ולכן שווה לבחון כל טענה נלהבת עם קצת ספקנות ולעקוב אחר העלות בפועל.
לסיכום
לולאות עצמן אינן חידוש - הן חלק בסיסי מתכנות כבר עשרות שנים, וגם דפוס הפעולה של סוכני AI מוכר מזה כמה שנים טובות. מה שבאמת משתנה הוא הגישה: לתכנן מראש איך הסוכן יעבוד באופן אוטונומי, ולוודא שהוא יודע באמת מתי הסתיים - לא רק מתי הוא חושב שהסתיים. לולאה טובה טובה בדיוק כמו הבודק שמפעיל אותה: משוב חישובי מהיר לכל מה שאפשר לבדוק בקוד, משוב הסקתי יקר יותר לכל מה שדורש שיקול דעת, ובן אדם שעדיין מחליט מתי לתת אור ירוק ומתי לעצור את הכל.
להמשיך לקרוא

כתבהAI
RAG ארגוני שבאמת עובד: הלקח מהמערכת הפנימית של Cerebras
רוב הדגמות של "מסד ידע ארגוני" הן גרף Obsidian מרשים שלא עוזר לאף אחד. חברת שבבי AI בנתה משהו משעמם בהרבה - ומדויק פי כמה. הנה איך זה עובד.

כתבהAI
בונה סוכני דפדפן שבאמת עובדים: CLI, CDP, ולולאת Sense-Act-Verify
מה למדתי מבניית סוכני AI אמינים שמפעילים דפדפן: למה CLI מנצח MCP לאוטומציה, איך מפעילים Chrome ישירות דרך CDP, ולולאת sense-act-verify שעוצרת כשלים שקטים.
מדריךAI
סרטוני AI עם Opus 5.5: הפרומפט הוא רק 10% מהתוצאה
מי שמנסה "פרומפט אחד וסרטון מוכן" מקבל סרטון גנרי. הפרומפט הוא רק 10% מהתוצאה: חוקי תנועה, מותג אמיתי, רפרנסים, סאונד ולולאת ביקורת עושים את השאר.
עקבו אחרינו
טיקטוק · X · אינסטגרם · טלגרם
מוכנים לאוטומציה?
בואו נבנה יחד מערכת שעובדת בשבילכם — לא להפך.