
LangFuse: לראות מה באמת קורה בתוך סוכני ה-AI שלכם
מאת גלעד דור לוי
LangFuse הוא כלי observability בקוד פתוח שנותן נראות מלאה לכל בקשה שעוברת דרך סוכן AI - מה נשלח למודל, כמה זה עלה, ואם התשובה הייתה בכלל טובה.

כשעובדים עם כלי קידוד AI כמו Claude Code, או בונים אפליקציית AI מותאמת אישית, מגיע שלב שבו "זה עובד" כבר לא מספיק. הלוגים נקיים, הטסטים עוברים, אין שגיאות - אבל העלויות קפצו פתאום, או שאיכות התשובות ירדה בלי סיבה ברורה. הבעיה: אין שום נראות למה שבאמת קורה בין הבקשה לתשובה. בדיוק לשם כך קיים LangFuse.
מה זה LangFuse
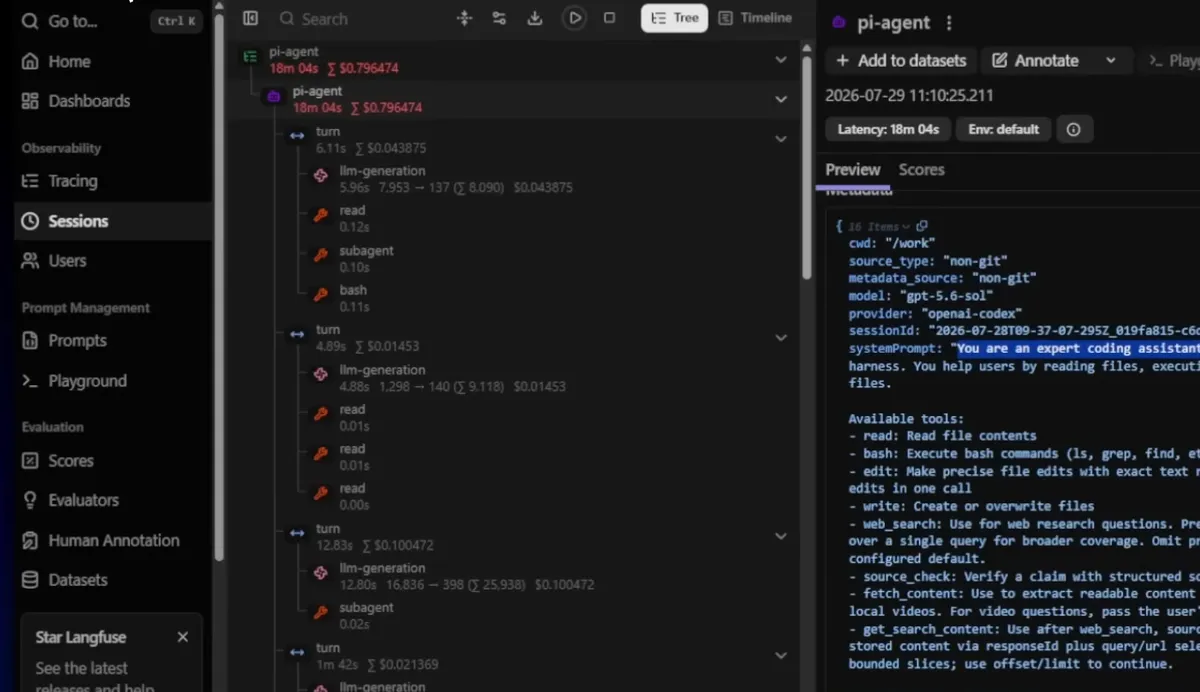
LangFuse הוא כלי observability בקוד פתוח (רישיון MIT), שאפשר להריץ בעצמכם או להשתמש בגרסה המנוהלת שלהם עם tier חינמי. הרעיון: תיעוד מלא (trace) של כל בקשה - מה בדיוק הועבר למודל (כולל system prompt מלא והגדרות כלים), מה הוא עשה עם זה, כמה זה עלה, וכמה זמן זה לקח. בקצר: רנטגן לתוך הסוכן.
למה זה קריטי דווקא עם סוכני קידוד
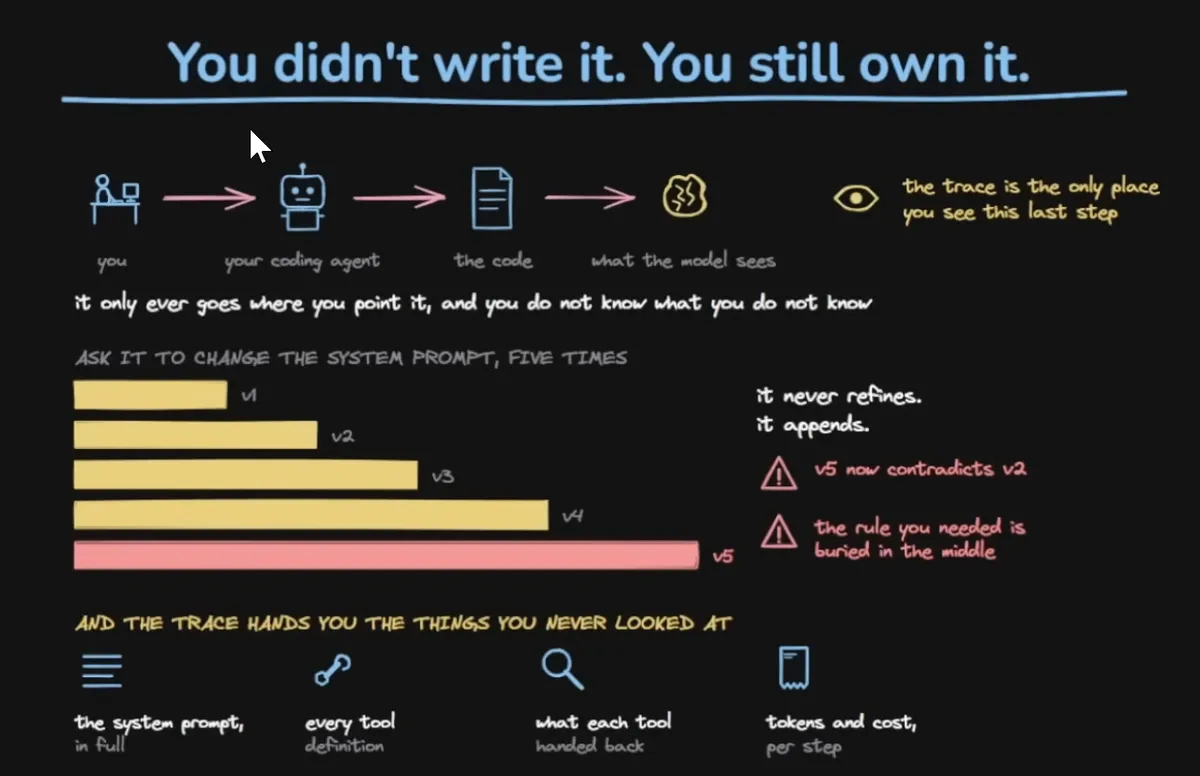
סוכני AI כמו Claude Code או Codex בונים בשבילכם קוד, בודקים שהוא עובד, ומדווחים הצלחה - אבל אתם כמעט אף פעם לא רואים בעצמכם מה בדיוק נשלח למודל. הבעיה המוכרת ביותר: system prompt שמתנפח עם הזמן. כשמבקשים מסוכן לעדכן system prompt כמה פעמים ברצף, הוא נוטה רק להוסיף לקיים במקום לכתוב מחדש - וכך נוצרות סתירות פנימיות שגורמות למודל "להתבלבל" בלי סיבה גלויה. בלי trace מלא, אין שום דרך לראות את זה.
הבדל נוסף שחשוב לדעת: כלים בקוד פתוח חושפים trace מלא כולל כל תוכן ה-system prompt והגדרות כל כלי. כלים סגורים חושפים הרבה פחות - רואים את הקריאות והתשובות, אבל לא בהכרח את מלוא ה-system prompt הפנימי.
מה רואים בפועל ב-trace
- כל שיחה (session) מתפרקת ל-traces, וכל trace מתפרק לתורות (turns) ולקריאות כלים בודדות
- עלות מדויקת לכל קריאה, כולל התחשבות ב-cache
- זמן תגובה (latency) לכל שלב
- לאפליקציות מבוססות RAG - בדיוק אילו שאילתות נשלחו לחיפוש, אילו מסמכים חזרו, ואיך נבחרו זו נקודה חשובה: אפליקציה יכולה להיראות תקינה לחלוטין - שום שגיאה, כל הטסטים עוברים - ועדיין לתת תשובה שגויה או לפעול בצורה לא רצויה. זה החלק שמתחת לפני המים שרק trace מלא חושף.
חיבור לסוכן קידוד
הפיצ'ר המעניין: לא רק שאתם רואים את ה-trace, אלא שסוכן הקידוד עצמו יכול לקרוא אותו - דרך skill ייעודי או MCP server של LangFuse. אפשר לבקש מהסוכן "תביא את ה-trace האחרון ותבין למה קריאת הכלי הזו נכשלה" - וזה נותן לו נראות מלאה גם על הקוד וגם על ההרצה הספציפית שגרמה לבעיה. זה שדרוג משמעותי מעל לוגים רגילים.
ניהול פרומפטים וגרסאות
תכונה נוספת: הוצאת ה-prompts מהקוד עצמו לניהול בתוך הפלטפורמה, עם versioning. גרסה אחת מסומנת כ-production, הקוד פשוט מבקש אותה לפי שם (עם cache מקומי כדי לא להוסיף latency), וכל trace נושא את מספר הגרסה שיצרה אותו - כך שאפשר לקשר ביצועים, עלות וציונים לגרסת prompt ספציפית.
הערכת איכות (Evaluation)
Trace מספר מה קרה, אבל לא אם התשובה הייתה טובה. לשם כך יש כמה מקורות לניקוד:
- פידבק משתמשים אמיתי (thumbs up/down)
- ביקורת אנושית של הצוות (QA, מומחי תוכן)
- בדיקות דטרמיניסטיות בקוד (למשל: האם יש ציטוט מקור)
- LLM כשופט - להערכת דברים סוביקטיביים יותר, כמו הזייות תשובות בעייתיות שסומנו כך יכולות להצטרף ל-dataset הערכה, כדי לוודא שבעיה שתוקנה לא חוזרת בעתיד (regression).
נקודה חשובה: מסכת מידע רגיש
חשוב לוודא ש-trace לא שומר מידע רגיש שאמור להיות מוסתר. גם אם מידע כזה לא נשלח בפועל למודל, הוא עלול "לדלוף" ללוגים של הפלטפורמה עצמה בלי ששמים לב - וכך נוצר עותק נוסף של מידע רגיש במקום אחר. שווה לבדוק את זה ספציפית.
אפשרויות אירוח
- Self-host: Docker Compose עם Postgres, Redis, ClickHouse, MinIO - הכי פשוט להרצה מקומית. יש גם תבניות פריסה ל-Railway, Kubernetes, AWS, Azure
- LangFuse Cloud: tier חינמי (כ-50,000 units בחודש - שימו לב שיחידות נספרות לפי observations, לא רק traces, כך ש-trace עשיר יכול "לצרוך" הרבה יחידות מהר) יש גם חלופות: Arize Phoenix (קליל יותר, אבל לא open source אמיתי - רישיון Elastic 2.0), ו-LangSmith (תמחור פשוט יותר - trace = יחידה אחת, אבל גם הוא לא open source).
לסיכום
ברגע שסוכן AI או אפליקציה מבוססת LLM עוברים מ"פרויקט צד" לייצור, נראות מלאה על מה שקורה בכל בקשה היא לא luxury - היא הכרחית. בלי זה, "זה עובד" זה בעצם רק "לא ראינו שגיאה עדיין".
עקבו אחרינו
טיקטוק · לינקדאין · X · אינסטגרם · טלגרם
מוכנים לאוטומציה?
בואו נבנה יחד מערכת שעובדת בשבילכם — לא להפך.