
אבטחת Zero Trust לסוכני AI: מה מלמד מדגם של 100 סוכנים
מאתגלעד דור לוי
הערכה של 100 סוכני AI מצאה שילוב יכולות מסוכן ב־98% מהמדגם. מה הנתון אומר, מה אינו מוכיח ואילו בקרות כדאי לבדוק לפני חיבור סוכן למערכות עסקיות.

דמיינו מתמחה מבריק אך מילולי להפליא. ביום הראשון לעבודה אתם נותנים לו את כל המפתחות: גישה לתיבת המייל, רשימת משימות, והוראה אחת - "תתחילו לעבוד". הוא לא ישן, לא לוקח הפסקות, ולא שואל שאלות מיותרות. זה בדיוק מה שקורה כשפורסים סוכן AI אוטונומי בעסק. עכשיו לשאלה הקשה: מה קורה כשמישהו אחר מצליח לשלוח לאותו מתמחה הוראה סמויה - מוסתרת בתוך מייל, מסמך, או עמוד אינטרנט שהוא קורא כחלק מהעבודה השוטפת? מחקר עצמאי שבדק 100 סוכני AI בסביבת ייצור מצא ש-98% מהם היו חשופים בו-זמנית לשלושה תנאים שביחד הופכים את התרחיש הזה מהיפותטי לזמין. ורק 11% עברו רף אבטחה בסיסי. Anthropic פרסמו לאחרונה playbook בן 36 עמודים על הנושא, ובעולם שבו מודלים חזקים הופכים למומחים באיתור פרצות אבטחה, ההגנה על הסוכנים שאתם מפעילים כבר לא אופציונלית. הנה מה שבאמת חשוב מתוך כל זה - לא השיווק, לא ההייפ, אלא הבקרות שבאמת עוצרות תוקף.
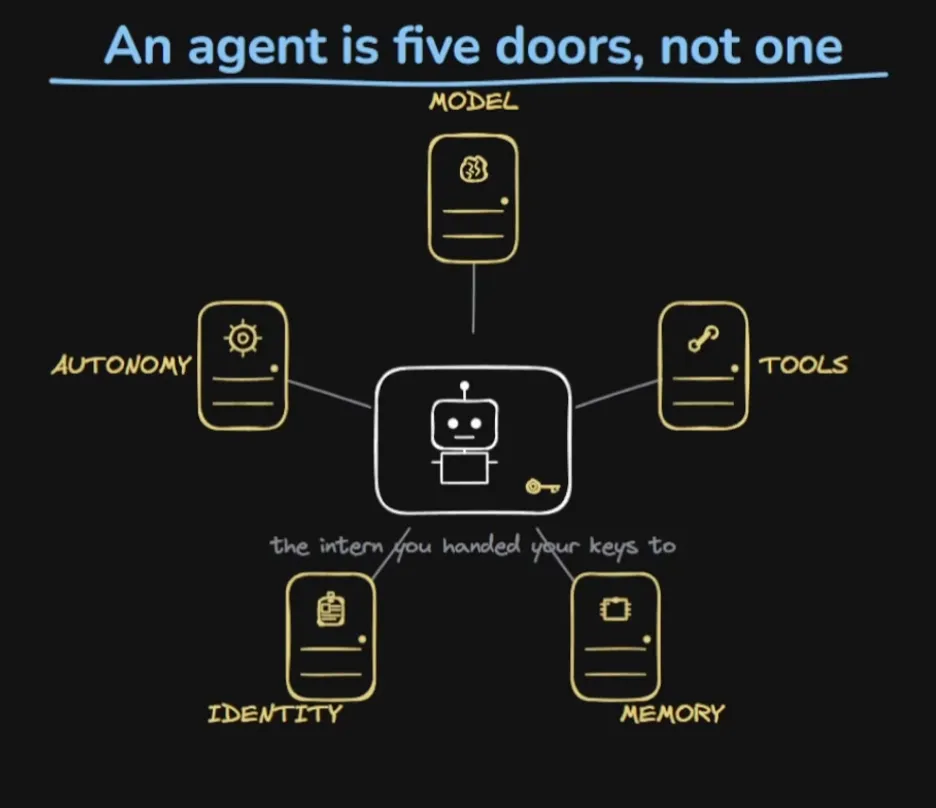
חמש הדלתות: מפת משטח התקיפה של סוכן AI
כדי להבין איפה סוכן AI פגיע, שווה לפרק אותו לחמישה רכיבים - כי כל אחד מהם הוא דלת נפרדת שתוקף יכול לנסות לפרוץ דרכה:
- המודל - השכבה שחושבת ומחליטה.
- הכלים (tools) - כל מה שהסוכן יכול להפעיל בפועל: לשלוח מייל, לערוך קובץ, לקרוא ממסד נתונים.
- הזיכרון - מה שהסוכן זוכר מהאינטראקציות הקודמות.
- הזהות - האישורים וההרשאות שהוא נושא איתו כדי להוכיח שמותר לו לפעול.
- האוטונומיה - החופש להחליט על הצעד הבא בלי לשאול אתכם קודם. תוקף לא צריך לפרוץ את כל המערכת. מספיק שהוא ימצא דלת אחת מבין החמש שנשארה פתוחה.
למה מודל ה"טירה" קרס - ומה מחליף אותו
הדרך המסורתית לאבטח מערכות היא מודל הטירה: קיר חיצוני חזק, ובתוכו הכל נחשב אמין ברגע שעבר בדיקת זהות בשער. זה עדיין המודל המנטלי שרוב האנשים משתמשים בו. אבל סוכן AI פנימי פשוט חורר בו חור, משלוש סיבות:
- מהירות מכונה - אין בן אדם שמאשר כל שלב וכל קריאה לכלי, אז אין שומר סף בלולאה.
- קריאת תוכן לא אמין כל היום - דפי אינטרנט, מיילים, מסמכים - כל אלה יכולים לשאת בתוכם הוראה מוסתרת שהסוכן פשוט יציית לה.
- גישה קבועה - המפתחות לא עוזבים את הכיס שלו. גישה 24/7 שהוא יכול להפעיל בכל רגע. מודל הטירה מניח שיש שומר סף אנושי ושכל מה שבפנים אמין. לסוכן AI אין אף אחד מהשניים - ולכן הקיר פשוט לא מחזיק.
מה שמחליף אותו נקרא Zero Trust: לעולם אל תסמכו, תמיד תאמתו. כל בקשה, בכל אחת מחמש הדלתות, נבדקת מחדש בכל פעם - גם אם היא מגיעה ממה שנראה כמו בפנים המערכת שלכם. החצי השני של הגישה הזו הוא הנחת פריצה: לא מתכננים למקרה שמישהו יצליח לחדור, מתכננים כאילו הפורץ כבר בפנים, לובש תג עובד לגיטימי. השאלה היחידה שבאמת חשובה היא עד כמה רחוק הוא יכול להגיע לפני שתדעו שהוא שם.
השילוש הקטלני: הנוסחה שהופכת סוכן למטרה קלה
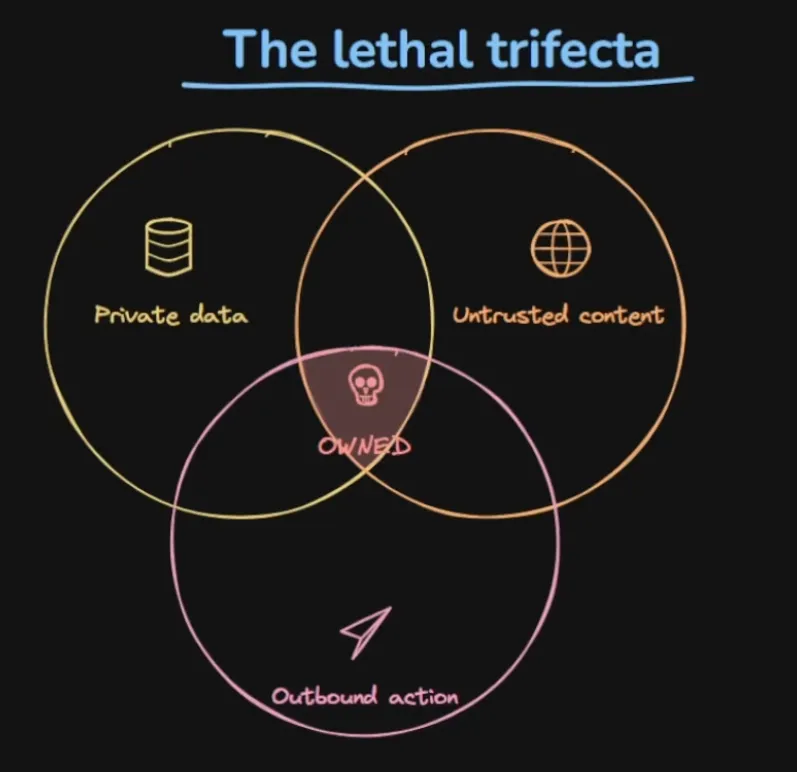
סיימון וויליסון טבע את המושג "lethal trifecta" (השילוש הקטלני) לתיאור שלושה מרכיבים שכל אחד מהם לבד די בטוח, אבל יחד יוצרים פרצה מושלמת:
- גישה לנתונים פרטיים.
- חשיפה לתוכן לא אמין (רשת פתוחה, מיילים נכנסים, מסמכים שהסוכן לא כתב).
- יכולת לבצע פעולה יוצאת - לשלוח משהו חזרה החוצה לעולם. מודל שקורא אינטרנט אבל לא נוגע בנתונים שלכם ולא יכול לשלוח כלום - לא ממש מסוכן. אבל ברגע שיש לסוכן גישה לשלושתם בו-זמנית, יש לתוקף בדיוק את השילוב שהוא צריך: התוכן הלא אמין מבריח הוראה, ההוראה מגיעה לנתונים הפרטיים, והפעולה היוצאת שולחת אותם החוצה.
הערת מחקר של Cloud Security Alliance מצטטת את הערכת AI Risk Quadrant Q2 2026: מתוך 100 סוכני AI מסחריים וציבוריים שנבדקו, 98% שילבו גישה לנתונים פרטיים, תוכן לא מהימן ופעולות יוצאות; 11% עברו את רף האבטחה של ההערכה. אלה תוצאות המדגם לפי שיטת ההערכה שלו, לא הוכחה ש־98% מכל הסוכנים נפרצו, ולא שיעור שנמדד בכל השוק.
מקרה בוחן: חבילת postmark-mcp המתחזה
לפי הודעת האבטחה הרשמית של Postmark מ־25 בספטמבר 2025, חבילת npm בשם postmark-mcp התחזתה למוצר של החברה. אחרי 15 גרסאות, גרסה 1.0.16 הוסיפה דלת אחורית שהעתיקה מיילים באמצעות BCC לשרת חיצוני. החבילה לא הייתה כלי רשמי, ושירותי Postmark עצמם לא נפגעו. ההודעה מאשרת את מנגנון הגניבה, אך לא מפרסמת מספר ארגונים שנפגעו או כמות מיילים יומית, ולכן אין כאן הצגה של אומדנים כאלה כעובדות מאומתות.
איזו בקרה באמת עוצרת תוקף - ואיזו רק מעכבת אותו
נקודת המוצא הנכונה היא לדמיין תוקף עייף לעולם - סבלני, אולי כבר בפנים. לכל בקרת אבטחה שיש לכם, שאלו שאלה אחת: היא הופכת את ההתקפה לבלתי אפשרית, או רק למייגעת? הרבה "פתרונות" הם בסך הכל מייגעים - הגבלות קצב, פורט לא סטנדרטי, מחרוזות שאילתה ארוכות. לתוקף יש זמן אינסופי, סבלנות אינסופית, עלות כמעט אפסית לכל ניסיון. הוא ישמח לכתוב סקריפט שינסה מאות מיליוני פעמים במהלך הלילה. בקרות מהסוג הזה הן חיכוך, לא אבטחה.
הבקרות שבאמת שורדות הן אלה שמסירות יכולת לגמרי:
- אישורים קשורים לחומרה (hardbound credentials) - סוד שפיזית קשור למכונה אחת, כך שמפתח מועתק פשוט לא יעבוד במקום אחר.
- טוקנים פגי תוקף - גישה שמתה תוך דקות, לא גישה שחיה לנצח.
- זהות קריפטוגרפית - הוכחה מי אתה שאי אפשר לזייף.
- נתיבי רשת שפשוט לא קיימים - אם אין מסלול בין A ל-B, שום כמות סבלנות לא תבנה אחד. טיפ מעשי נוסף מה-playbook: תנו ל-AI לטפל בתיעוד, לא בהחלטות. ה-AI יכול לרשום הערות, לאסוף ראיות, לנסח טיוטת פוסט-מורטם - כל העבודה המייגעת. אבל בני אדם צריכים להישאר עם ההחלטות שבאמת חשובות: מה לחשוף, למי להתקשר, איך נראית ההכלה.
חמש משפחות איומים
OWASP קיטלגו 17 דרכים שונות לתקוף סוכן AI. ב-playbook של Anthropic הן דוחסו לחמש משפחות עיקריות, וכל אחת ממופה ישירות לאחת מחמש הדלתות שראינו קודם:
- הזרקת פרומפט (prompt injection) - טקסט שהמודל קורא נושא הוראה שהוא בסוף פשוט מציית לה. דלת המודל.
- ניצול לרעה של כלים ומשאבים - סוכן שיוצא משליטה עם שרת MCP שיש לו גישה אליו. דלת הכלים.
- ניצול לרעה של זהות והרשאות - סוכן שיורש הרבה יותר הרשאות ממה שהוא בפועל צריך. דלת הזהות.
- סיכוני שרשרת אספקה - חבילות זדוניות או מודולים מורעלים שנמשכים פנימה, כמו במקרה postmark-mcp. חוצה את כל הדלתות.
- הרעלת זיכרון והקשר - שחיתות של מה שהסוכן זוכר כך שהוא מתנהג לא נכון בהמשך, או שליפת מידע מזוהם ממסד כמו RAG. דלת הזיכרון. והדלת החמישית, האוטונומיה, היא זו שהופכת את כל אלה מבעיה איטית לבעיה מהירה.
מספרים מהשטח, ומודל בגרות בשלושה שלבים
דוח The State of AI Agent Security 2026 של Gravitee מתבסס על סקרים של 919 מנהלים ואנשי מקצוע. הדוח מציין כי 88% מהארגונים בסקר דיווחו על אירועי אבטחה או פרטיות מאושרים או חשודים בשנה האחרונה (עמוד 6). מדובר בדיווח עצמי בסקר של ספק, כולל חשדות; לא בבדיקה עצמאית המאשרת פריצה בכל ארגון, ולא באותו מדגם של 100 סוכנים.
המסגרת מארגנת את היישום בשלושה שלבים: בסיס (foundation) - הרף המינימלי שרוב הארגונים צריכים לשאוף אליו, ארגוני (enterprise), ו-מתקדם - לפריסות בסיכון גבוה או סביבות רגולטוריות מחמירות.
מה שמעניין הוא שכלים כמו Claude Code כבר תומכים ברבים מהיסודות האלה מהקופסה, אם רק מפעילים אותם:
- הרשאות deny-by-default - כל פעולת כתיבה או הרצה דורשת אישור מפורש, בנוסף להרצה ב-sandbox ולהגבלות גישת כתיבה.
- תיעוד ומעקב (auditing) - מטריקות OpenTelemetry ולוגים מלאים של כל פעולה, עם מזהה session ייחודי לכל ריצה.
- ניטור התנהגות - זיהוי הזרקת פקודות שמסמן פקודות חשודות גם כשהן תואמות דפוס מאושר, עם fail-closed כברירת מחדל.
- בקרת קלט ופלט - סניטציה של קלטים, הגבלות אורך, ורשימה שחורה של פקודות מסוכנות.
- בידוד אחסון אישורים - קלוד קוד שומר credentials בחנות האישורים של מערכת ההפעלה, עם אפשרות אינטגרציה לכספות סודות חיצוניות.
- בידוד זיכרון - הפרדה בין sessions ומשתמשים שונים כברירת מחדל. כל אלה מוגדרים בעיקר דרך קובץ settings.json - וזה בדיוק המקום שכדאי להשקיע בו זמן להדק. מי שרוצה שכבה נוספת יכול להוסיף כלים כמו Microsoft Agent Governance Toolkit (קוד פתוח, רישיון MIT) שנותן אכיפת מדיניות, זהות Zero Trust, ובידוד הרצה מעל שכבת ההרשאות הטבעית של הסוכן.
גישה מבוססת-סיכון למי שלא צריך Zero Trust ארגוני מלא
לא כל אחד מפעיל סוכן AI בתוך ארגון עם דרישות רגולציה. למי שבונה לבד או בצוות קטן, יישום Zero Trust מלא יוצר הרבה חיכוך מיותר - כל פעולה מבקשת אישור. הגישה המעשית יותר היא ניהול סיכונים לפי הקשר:
- אם מריצים סוכן אוטונומי 24/7 בפרויקט צד, בידוד ב-VM נפרד (למשל דרך hypervisor) שמנותק לגמרי משאר מערכת הקבצים כבר נותן שכבת הגנה משמעותית - גם אם לא נועלים את כל הדומיינים שהסוכן יכול לגשת אליהם, זה סיכון סביר כשאין נתונים רגישים אמיתיים במשחק.
- מפתחות API כדאי לנעול בכל מקום שאפשר: הגבלות קרדיט על מפתח ספציפי, הרשאות מוגדרות, וקישור לפרויקט ספציפי - רוב הספקים כבר תומכים בזה.
- כספות סודות (כמו AWS Secrets Manager, Infisical, Bitwarden) לא חסינות לפריצה בעצמן, אבל להגנה על סודות ברמת production הן שוות את ההשקעה. הרעיון המרכזי: זהו את מלוא ה"שטח" שהסוכן שלכם נוגע בו, ובחרו את רמת הבידוד וההרשאה לפי מה שבאמת נמצא בסיכון - לא לפי כמה שהאבטחה "נשמעת רצינית".
לסיכום
הכוח שנותנים לסוכני AI רק גדל - יותר גישה, יותר אוטונומיה, יותר חופש לפעול לבד. ובמקביל, עלות הפריצה קרסה: מה שדרש פעם מומחה וחודשים של עבודה, סוכן קוד בידיים הלא נכונות יכול לנסות ללא הפסקה, מסביב לשעון. Zero Trust לא אומר לבנות קיר גבוה יותר - הקיר כבר לא רלוונטי. זה אומר לבדוק כל בקשה בכל אחת מחמש הדלתות, בכל פעם, ולתכנן כאילו הפורץ כבר בפנים. השאלה שבאמת קובעת אם אתם מוגנים היא לא כמה בקרות הפעלתם, אלא כמה מהן באמת הופכות התקפה לבלתי אפשרית - ולא רק למייגעת.
Anthropic: מדריך Zero Trust לסוכני AI (PDF)
להמשך העבודה
לחיבור בין הכלים לשגרת העבודה, קראו את מדריך מחסנית Agentic Engineering: ממשקים, מנויים ו־Skills ובחנו את הבחירות מול המשימות והמגבלות שלכם.
להמשיך לקרוא
מדריךAI
100 קודים שימושיים ל־ChatGPT
ספריית קיצורי דרך מעשית לכתיבה, מחקר, למידה, שיווק ופרודוקטיביות — עם העתקה בלחיצה.

כתבהAI
Harness, Loop Engineering ו-LLMOps: איך סוכני AI באמת נשלטים
Agent harness, loop engineering ו-LLMOps הם לא באזז ריק - שלושה רעיונות פשוטים שביחד הופכים מודל שפה למערכת AI עסקית שאפשר לסמוך עליה.

כתבהAI
LangFuse: לראות מה באמת קורה בתוך סוכני ה-AI שלכם
LangFuse הוא כלי observability בקוד פתוח שנותן נראות מלאה לכל בקשה שעוברת דרך סוכן AI - מה נשלח למודל, כמה זה עלה, ואם התשובה הייתה בכלל טובה.
עקבו אחרינו
טיקטוק · X · אינסטגרם · טלגרם
מוכנים לאוטומציה?
בואו נבנה יחד מערכת שעובדת בשבילכם — לא להפך.