
מה למדתי ב-Harness Club של Y Combinator - למה ה-harness חשוב יותר מהמודל
מאתגלעד דור לוי
מה למדתי משלוש הרצאות ב-Harness Club של Y Combinator - על היררכיית זיכרון, אימון מקומי לגמרי, ולמה harness דק מנצח על harness מורכב.

צפיתי בהקלטה של Harness Club של Y Combinator - ערב שהוקדש כולו ל-harness של סוכני AI: הליבוש, הכלים, הזיכרון, ולוגיקת התזמור שעוטפת מודל, לא המודל עצמו. נהוג לזלזל ב-harness ולכנות אותו "רק wrapper" או "רק prompt engineering". ההרצאות הציגו טיעון חזק שהזלזול הזה טועה, ונתון סטטיסטי אחד מהערב ביסס את הטיעון הזה יותר מכל ויכוח.
הנתון ששינה לי את הראייה על זה
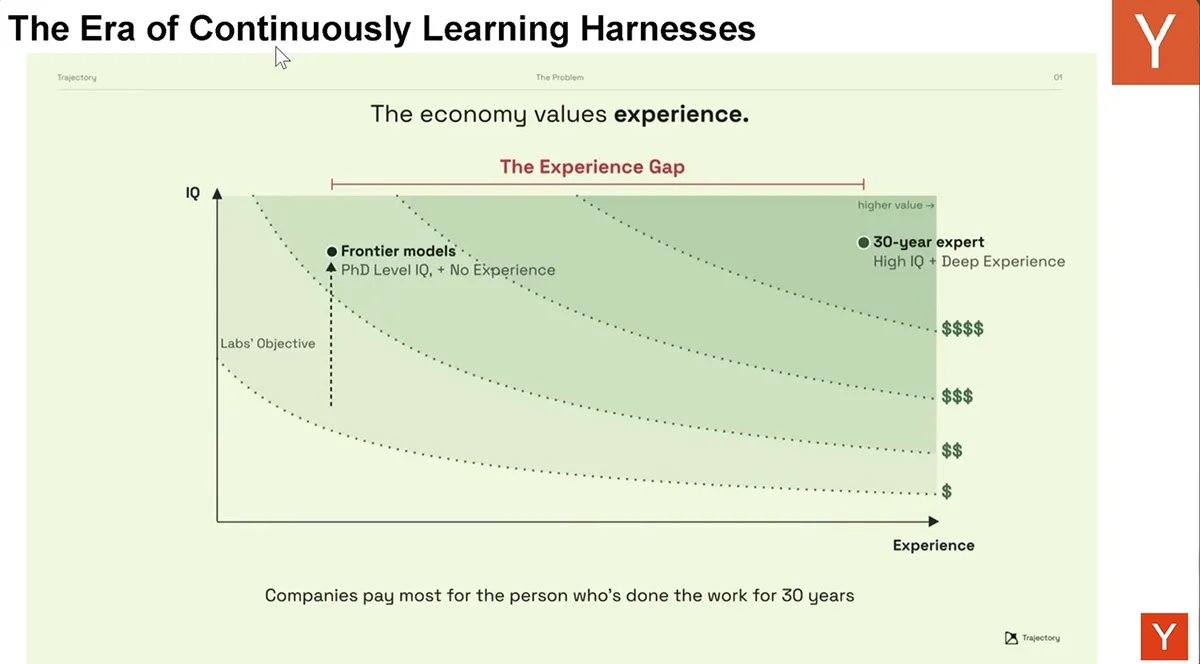
ב-ARC-AGI, benchmark שנועד ספציפית למדוד כמה מהר מערכת מסתגלת לבעיה באמת חדשה, Claude Opus קיבל ציון של 30 אחוז עם harness מוקדם ולא-מותאם. עם עיצוב harness טוב יותר בלבד, על אותם בדיוק משקלי מודל, המספר הזה עלה ל-95 אחוז. מערכת נפרדת מ-Nvidia הגיעה ל-100 אחוז. אותה אינטליגנציה, תוצאה שונה לגמרי, אך ורק מהאופן שבו המערכת שסביבה נבנתה. זה לא prompt engineering. זה מנוף אמיתי.
סקיצה קצרה של איך הגענו לכאן
אחד הדוברים עבר על ההיסטוריה, ושווה לסכם אותה. harness מוקדמים של מודלי שפה ב-2019 בקושי היו harness בכלל: system prompt, לולאה, ותנאי עצירה. במהלך השנים הבאות, התחום הוסיף יכולת שכבה אחר שכבה: דוגמאות few-shot, ואז חשיבה בשלבים (chain-of-thought), ואז היכולת לקרוא לכלים חיצוניים (Toolformer, WebGPT), ואז היכולת של מודל לקרוא ולכתוב לזיכרון שלו במקום רק להוסיף לתמליל שהולך וגדל (MemGPT), ואז היכולת לשרשר כלים ל-skills ניתנים לשימוש חוזר ולשמור אותם לפעם הבאה (מאמר Voyager, שנבנה על Minecraft). אחרי זה הגיעו דפוסי multi-agent: מודל שמהרהר ומתקן את הפלט של עצמו, מטיל תת-סוכנים קבועים שאפשר לשלוח להם הודעה מאוחר יותר, ולבסוף מבנים רקורסיביים שבהם סוכן יכול להטיל עוד סוכנים כדי לפתור חלקים ממשימה גדולה יותר.
התזוזה הכי חדשה והכי מעניינת היא harness שמשתפרים בעצמם. במקום system prompt קבוע, חלק מהמערכות היום מחפשות בין פרומפטים מועמדים ושומרות את הטובים יותר. הצעד הבא אחרי זה הוא harness שיכול לכתוב מחדש את הקוד של עצמו, לא רק את הפרומפט - למעשה מפתח את הארכיטקטורה של עצמו לאורך זמן, בהתאם לביצועים של כל גרסה.
להתייחס להקשר כמו היררכיית זיכרון
סת', שהציג את Prime Agent (harness שמשתפר בעצמו, שנבנה ב-Prime Intellect), מסגר את זה בצורה שמצאתי באמת שימושית: לחשוב על כל מה שיש למודל גישה אליו כמו היררכיית זיכרון, דומה לאיך שיש למחשב caches. משקלי המודל הם הכי מהירים והכי זולים לגישה, אבל גם הכי יקרים לשינוי. ההקשר הפעיל הוא הבא בתור, והוא מוגבל: ברגע שנגמר המקום, צריך compaction כדי לסכם היסטוריה ולהמשיך. מעבר לזה, סביבת קוד חיה (Python REPL שהסוכן יכול לקרוא ולכתוב בו משתנים) עובדת כמו שכבה מתחת להקשר הפעיל: היא נותנת לסוכן להחזיק ולתפעל state בלי לשלם על כל ערך בטוקנים. תת-סוכנים עובדים בצורה דומה. מעבירים משימה צרה עם בדיוק ההקשר שהיא צריכה, והם מדווחים בחזרה תקציר במקום להציף את ההקשר של ההורה בכל מה שעשו בדרך.
החלק שהכי אהבתי: תת-סוכנים במערכת הזו הם קבועים וניתנים לפנייה. session הורה יכול להטיל אחד, לתת לו לסיים ולהיכנס למצב idle, ולשלוח לו הודעה שוב מאוחר יותר עם כל ההקשר שלם - במקום לזרוק הכל ולהתחיל session חדש בכל פעם. ולגבי הערכה: במקום רק לבדוק אם מודל פתר משימה בתוך תקציב קבוע, שווה לבדוק איפה הביצועים באמת מגיעים לרמה - plateau - ככל שנותנים לו יותר זמן ויותר טוקנים. השוואה בין שני מודלים באותו תקציב קבוע יכולה להסתיר הבדלים אמיתיים באיך כל אחד מהם מנצל זמן נוסף.
להריץ סוכנים ברמת frontier לגמרי על המכשיר שלכם
ג'ון הציג את Open Jarvis, פרויקט של סטנפורד שבנוי סביב תצפית פשוטה: מודלים מקומיים, שרצים על המכשיר, כיום מפגרים אחרי ה-frontier רק בשישה עד שנים עשר חודשים, לא שנים. ההצעה היא מחסנית AI אישית - inference של המודל, לוגיקת הסוכן, זיכרון, ולמידה - שרצה לגמרי על המחשב הנייד או תחנת העבודה שלכם במקום בענן. הסיבות שזה חשוב: אין עלות API לכל שאילתה, אין נתונים אישיים שעוזבים את המכונה שלכם, וצריכת אנרגיה נמוכה בהרבה.
החלק החכם ביותר בעיצוב: במקום לנסות להפוך מודל מקומי קטן לחכם יותר בזמן ה-inference, הם משתמשים במודל ענן גדול פעם אחת, offline, כדי לבצע אופטימיזציה ל-harness המקומי עצמו - מכוונים את הפרומפטים, הכלים, וההגדרות למודל ולמשימה הספציפיים לפני שמשהו רץ מקומית. אינטליגנציית הענן משלמת על עבודת העיצוב מראש; ה-inference היומיומי בפועל נשאר לגמרי מקומי וזול. תוצאות מדווחות: עד בערך פי 800 פחות עלות בהשוואה להרצת אותו עומס עבודה דרך מודל ענן, עם latency נמוך יותר גם כן, ואיכות שמתחרה במחסניות ענן במשימות אישיות יומיומיות - גם אם היא עדיין מפגרת במשימות הקשות ביותר.
מה ה-harness הפנימי של YC עצמה לימד אותם
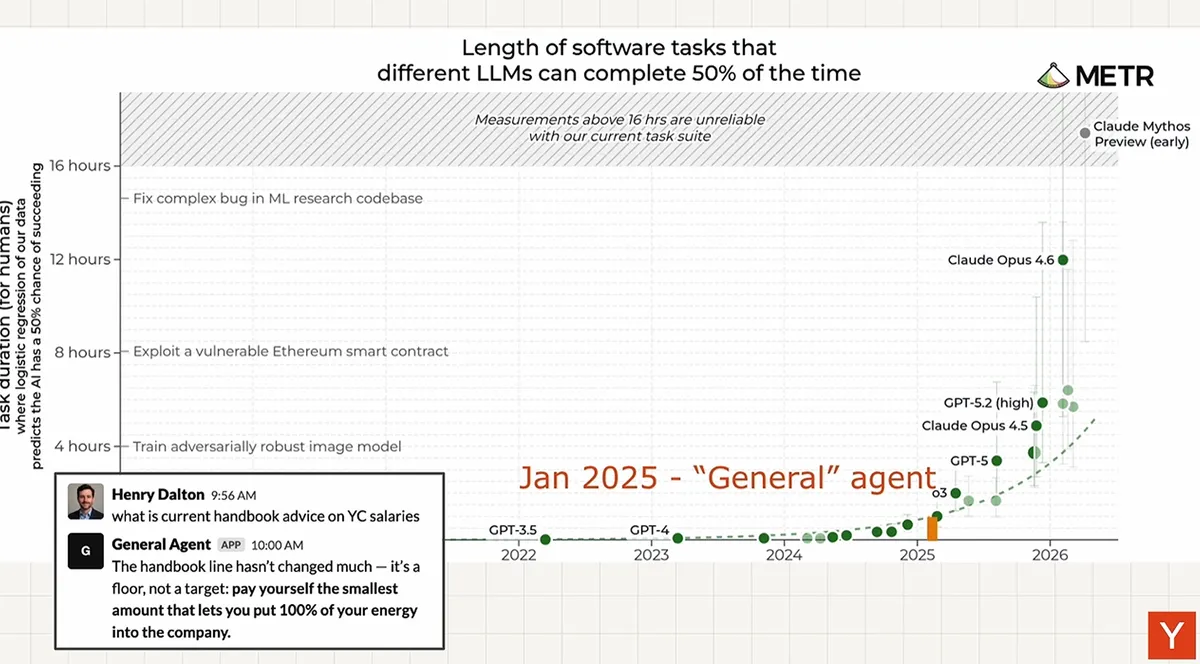
ג'וש ורייגן עברו על QM, ה-harness הפנימי של סוכן ב-YC, והחלק הכי שימושי היה ההיסטוריה של מה שלא עבד לפני שהם הגיעו לעיצוב הנוכחי. הסוכן הפנימי הראשון של YC, שנבנה בינואר 2025, היה system prompt פשוט ולולאת כלים משותפת לכולם. הוא השתפר באופן ניכר ככל שהמודלים הבסיסיים השתפרו, בלי שום שינוי אחר. מאוחר יותר, לתת לסוכנים מחשב sandbox משלהם (אותו דפוס שכלים כמו Claude Code או Codex משתמשים בו) היה קפיצת יכולת אמיתית, אבל הרצת צי של עשרות כאלה עבור כל עובד הפכה לכיבוי שריפות ידני מתמיד - מתואר כבעיית "whack-a-mole" של ניהול מופעים אחד-אחד.
התיקון של QM היה להפסיק להתייחס ל-sandbox כבית של הסוכן. ה-state עכשיו חי מרכזית, כך ששיחה וההקשר שלה לא כלואים במכונה אחת, ו-sandbox הופך למשאב שהסוכן פונה אליו לפי דרישה: קטן למשימה קלה, גדול יותר כשהמשימה באמת דורשת יותר חישוב, ומשוחרר שוב ברגע שהמשימה הסתיימה. ה-harness עצמו נשמר דק בכוונה: שלושה כלי ליבה (הרצת קוד ב-sandbox מרוחק, קריאה וכתיבה לאחסון אובייקטים, ופרסום אפליקציות web פנימיות קטנות), בתוספת כמה כלים קטנים יותר לזיכרון ומשימות מתוזמנות. הסוכן יכול גם לבחור בעצמו איזה מודל או ספק מטפל במשימה נתונה, מה שמתברר כדרך מעשית לעקוף סירוב של מודל ספציפי למשימה לגיטימית אך רגישה, פשוט על ידי מעבר לספק אחר.
שתי בעיות שהן עדיין לא פתרו לגמרי שוות ידיעה לפני שבונים משהו דומה. ראשית, סוכנים נוטים לוותר מוקדם מדי על משימות ארוכות, אז הם הוסיפו תקציב מפורש - לפעמים נמדד בשעות שעון-קיר ולא בכמות טוקנים - שהסוכן לא רשאי לוותר לפני שהגיע אליו. שנית, וקשה יותר: סוכנים לא מבינים באופן טבעי הקשר חברתי או ארגוני. בן אדם יודע אינטואיטיבית איזה מידע בסדר לשתף באיזה חדר. סוכן לא יודע, אלא אם מערכת ההרשאות סביבו בנויה מספיק בקפידה כדי לאכוף את הגבול הזה בשבילו.
איפה זה משאיר אותי
החוט המשותף בין שלוש ההרצאות: המודל כבר לא המוצר, או לפחות לא כל המוצר. מה שבונים סביבו - איך הוא מנהל את הזיכרון וה-state של עצמו, איך הוא מחליט מתי להטיל עזרה ומתי לעצור, כמה זול ובטוח הוא יכול לרוץ - זה איפה שרוב העבודה ההנדסית האמיתית, ורוב שיפורי הביצועים האמיתיים, קורים היום בפועל.
להמשיך לקרוא

כתבהAI
Harness, Loop Engineering ו-LLMOps: איך סוכני AI באמת נשלטים
Agent harness, loop engineering ו-LLMOps הם לא באזז ריק - שלושה רעיונות פשוטים שביחד הופכים מודל שפה למערכת AI עסקית שאפשר לסמוך עליה.
כתבהAI
ארמין רונכר על harness מינימלי, אמון, והממשק שאף אחד עדיין לא פתר
ארמין רונכר, יוצר Flask ומייסד-שותף של Earendil, מסביר למה harness מינימלי מנצח, למה לאוטונומיה מלאה יש תקרה אמיתית, ולמה קוד פתוח אפשר לשפוט רק בדיעבד.
מדריךAI
סרטוני AI עם Opus 5.5: הפרומפט הוא רק 10% מהתוצאה
מי שמנסה "פרומפט אחד וסרטון מוכן" מקבל סרטון גנרי. הפרומפט הוא רק 10% מהתוצאה: חוקי תנועה, מותג אמיתי, רפרנסים, סאונד ולולאת ביקורת עושים את השאר.
עקבו אחרינו
טיקטוק · X · אינסטגרם · טלגרם
מוכנים לאוטומציה?
בואו נבנה יחד מערכת שעובדת בשבילכם — לא להפך.